에이전트 쇼핑 소송과 Qwen3.8 1M 컨텍스트
아마존-퍼플렉시티 항소심 문서, Qwen3.8-27B NVFP4 1M 컨텍스트 vLLM 설정, llama.cpp 임베딩 속도 절반 문제, GIMP MCP 연동까지 2026년 9월 16일 로컬 AI 소식을 실무 관점에서 정리했습니다.
- 발행
- 수정
- 없음
- 읽는 시간
- 약 3분
- 근거 자료
- 5건 공식 2 · 커뮤니티 3
이 글로 알 수 있는 것
- AI 에이전트가 내 계정으로 다른 사이트를 대신 쓰는 일이 왜 법적 쟁점이 되는지
- Qwen3.8-27B로 100만 토큰 컨텍스트를 띄운 설정과 그 한계
- 사내 RAG에서 임베딩과 답변 생성을 한 서버에 둘 때 생기는 문제
목차 · 소제목 6개
오늘 고른 소식 네 가지
안녕하세요, 거노쌤입니다. 오늘은 에이전트 자동화의 법적 리스크 한 건과 로컬 LLM 운용 이슈 세 건을 골랐습니다. 모두 “그래서 내 작업 환경이 뭐가 달라지나”에 걸리는 것들입니다.
아마존 대 퍼플렉시티, 에이전트가 대신 장을 보면
9월 14일 해커뉴스에서 216점, 댓글 217개를 모은 링크는 뉴스 기사가 아니라 제9연방항소법원 사건 문서공식였습니다. 2026년 8월 4일자 아마존 대 퍼플렉시티 건입니다. 저는 법률가가 아니라 판시 내용을 요약하지는 않겠습니다. 다만 커뮤니티가 이 문서에 이렇게 몰린 이유는 분명합니다. 에이전트가 사용자 계정으로 남의 서비스에 로그인해 대신 행동하는 것을 어디까지 허용할지가 걸려 있기 때문입니다.
실무에서 바로 걸리는 지점은 사내 자동화입니다. 브라우저 자동화 에이전트에 회사 계정을 물려 외부 쇼핑몰, 항공권 사이트, 공급사 포털에서 주문을 돌리는 흐름을 만들어 두셨다면, 기술 문제가 아니라 약관 문제가 먼저 터집니다. 오늘은 판결을 기다리기보다 우리 자동화가 어떤 사이트에 어떤 계정으로 들어가는지 목록부터 뽑아 두는 게 실속 있습니다.
Qwen3.8-27B NVFP4로 1M 컨텍스트 띄우기
r/LocalLLaMA에 NVFP4 양자화 모델로 100만 토큰 컨텍스트를 올린 설정커뮤니티이 올라왔습니다. 는 모델을 가볍게 압축하는 것이고, NVFP4는 엔비디아 계열 4비트 포맷입니다. 작성자가 공개한 vLLM 실행 옵션의 핵심만 추리면 이렇습니다.
vllm serve unsloth/Qwen3.8-27B-NVFP4 \
  --tensor-parallel-size 4 \
  --gpu-memory-utilization 0.91 \
  --kv-cache-dtype fp8 \
  --max-num-batched-tokens 16384 \
  --speculative-config '{"method": "mtp", "num_speculative_tokens": 3}' \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_xml --enable-auto-tool-choice \
--max-model-len 1000000눈여겨볼 건 세 가지입니다. KV 캐시를 fp8로 낮춰 긴 의 메모리를 줄였고, MTP 방식 추측 디코딩으로 3개를 미리 뽑으며, VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 환경변수로 길이 제한을 풀었습니다. 다만 GPU 4장을 텐서 병렬로 묶은 구성이라 개인 책상에서 그대로 따라 하기는 어렵습니다. 작성자 본인도 “제대로 한 건지 아직 모르겠다”고 적었고, 실측 속도 수치는 없습니다. 긴 컨텍스트는 열어 두는 것보다 실제로 채웠을 때 초당 몇 토큰이 나오는지가 중요하니, 따라 하실 분은 128k 정도부터 측정해 보시길 권합니다.
같은 모델로 임베딩까지, 대신 생성 속도 절반
Qwen3.8 27B 임베딩 관련 글커뮤니티에서는 llama.cpp에 --embedding --pooling mean을 주면 품질이 쓸 만하게 나오는데, 그 순간 토큰 생성 속도가 평소의 절반으로 떨어진다는 보고가 나왔습니다. 모델 하나로 검색용 벡터와 답변 생성을 다 해결하려는 구성에서 바로 부딪히는 문제입니다.
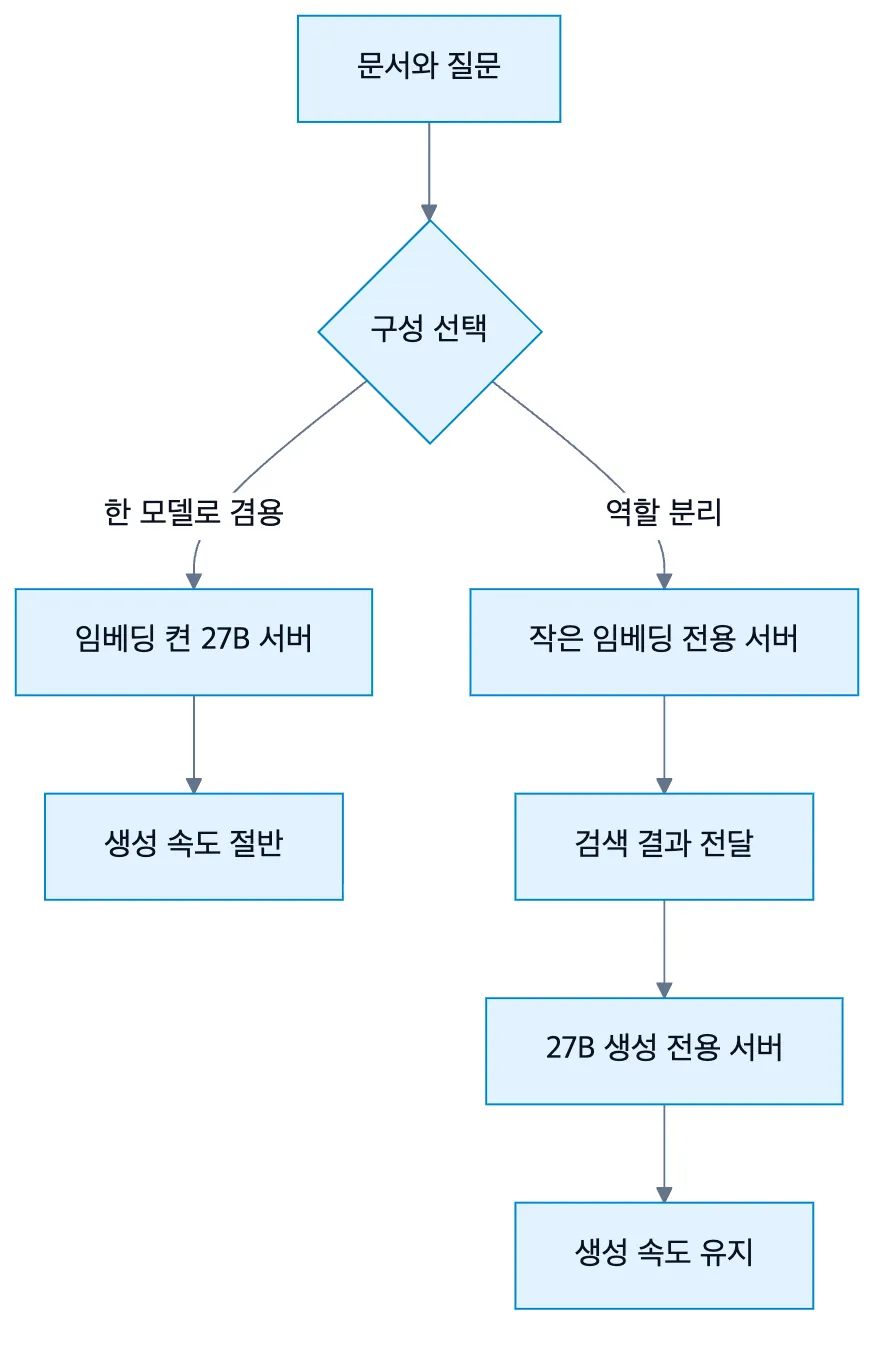
사내 를 만드신다면 지금은 역할을 쪼개는 쪽이 안전합니다. 임베딩은 작고 빠른 전용 모델에 맡기고, 27B는 답변 생성만 시키는 구성이요. 포트를 두 개 띄우는 수고가 늘지만 대기 시간이 두 배로 늘어나는 것보다는 낫습니다.
로컬 모델이 GIMP를 직접 만지기 시작했다
llama.cpp에 GIMP를 MCP로 붙인 사례커뮤니티도 올라왔습니다. 는 모델이 외부 프로그램의 기능을 도구처럼 호출하게 해 주는 규격입니다. 작성자는 gimp-mcp공식 서버를 설치하고 설정 JSON을 만든 뒤, llama-server 실행 줄에 --mcp-servers-config 옵션으로 경로를 넘겼습니다.
“꽃 그림 그려 줘”를 시킨 첫 결과물은 본인 표현으로도 별로였습니다. 그림 솜씨를 기대할 대목은 아니라는 뜻입니다. 대신 쓸모는 다른 데 있습니다. 이미지 100장 크기 맞추기, 워터마크 얹기, 레이어 정리 같은 반복 편집을 말로 지시하는 통로가 열린 겁니다. 로컬 모델이니 편집 대상 이미지가 밖으로 나가지 않는다는 점도 사내 자료를 다룰 때 의미가 있습니다.
오늘 할 일
- 우리 팀 자동화가 외부 사이트에 어떤 계정으로 로그인하는지 목록을 만들어 두기.
- 로컬 RAG를 쓰고 있다면 임베딩과 생성을 같은 서버에 물려 두지 않았는지 확인하기.
- 반복 이미지 편집 작업이 있다면 gimp-mcp를 테스트 폴더 사본에만 붙여 한 번 돌려 보기.
참고한 자료 · 5건
- 공식 · 2
- Amazon vs. Perplexity 제9연방항소법원 사건 문서 (Justia 게재)law.justia.com
- maorcc/gimp-mcp 저장소github.com
- 커뮤니티 · 3 — 소식을 찾은 곳. 사실 확인은 공식 자료로
- Qwen3.8-27B-NVFP4 1M context. So far so good.reddit.com
- Qwen3.8 27B with embeddingsreddit.com
- Connected a local model to GIMP via MCP tools using llama.cppreddit.com
수정 이력
이어서 읽기
이번 주 해외에서 새로 나온 것 가운데 일에 쓸 만한 것만 골라, 원문 링크와 함께 보내 드립니다.
팀에 이런 자동화를 들이고 싶다면 강의·도입 문의로 연락 주세요.