Jev 흉내내기와 Qwen-Image-2.1 공개
분류 전용 모델 Jev·Laya 논쟁, llama.cpp logprobs로 분류기 만드는 법, Qwen-Image-2.1 오픈웨이트, ZCode 오픈소스화까지 2026년 9월 21일 로컬 AI 브리핑.
- 발행
- 수정
- 없음
- 읽는 시간
- 약 4분
- 근거 자료
- 9건 공식 2 · 커뮤니티 7
이 글로 알 수 있는 것
- 답을 '고르기만' 하는 AI 모델(Jev·Laya)이 무엇이고, 어디까지 믿을 수 있는지
- 이미 가진 AI 모델로 스팸·문의 분류기를 만드는 방법
- Qwen-Image-2.1을 회사 일에 써도 되는지 (라이선스)
목차 · 소제목 6개
오늘 고른 소식 네 가지
안녕하세요, 거노쌤입니다. 오늘 r/LocalLLaMA 타임라인은 절반이 ‘Jev’ 이야기였습니다. 뭐가 그렇게 대단하냐는 글과, 그거 그냥 분류기 아니냐는 글이 나란히 올라왔어요. 정리하면서 실무에 바로 붙일 수 있는 부분만 골랐습니다.
1. Jev 열풍, 그리고 오픈 대안 Laya
Jev는 TypeSafe가 내놓은 ‘결정 전용’ 모델입니다. 텍스트를 생성하는 대신 상태(이메일, 티켓, JSON)와 질문을 받아 한 번의 순전파로 라벨·점수·참/거짓을 뱉습니다. 출력이 문장이 아니니 파싱할 것도, 환각도 없습니다.
여기에 대한 대안이 Laya커뮤니티입니다. Apache 2.0이고 체크포인트가 셋입니다. ModernBERT-large 기반 421M 영어 모델, mmBERT-base 기반 322M 다국어 모델(100개 이상 언어), 그리고 typed-decisions 특화 버전. GPU에서 33~40ms면 답이 나옵니다.
다만 모델 카드가 한계를 솔직하게 적어 둔 점이 더 인상적입니다. 없이는 typed-decisions에서 거의 찍기 수준이고, 선택지가 50개를 넘어가면 정확도가 꺾입니다. Banking77에서는 0.425로, Jev의 0.870과 차이가 큽니다. Jev 수치는 직접 붙여 본 게 아니라 제3자 보고값이라는 단서도 붙어 있고요.
같은 날 laya.cpp커뮤니티도 올라왔습니다. ggml과 커스텀 CUDA 커널로 짠 C++ 추론기라 파이썬·파이토치가 필요 없습니다. RTX PRO 6000 Blackwell(450W 제한) 기준 초당 처리 질문 수는 아래와 같습니다.
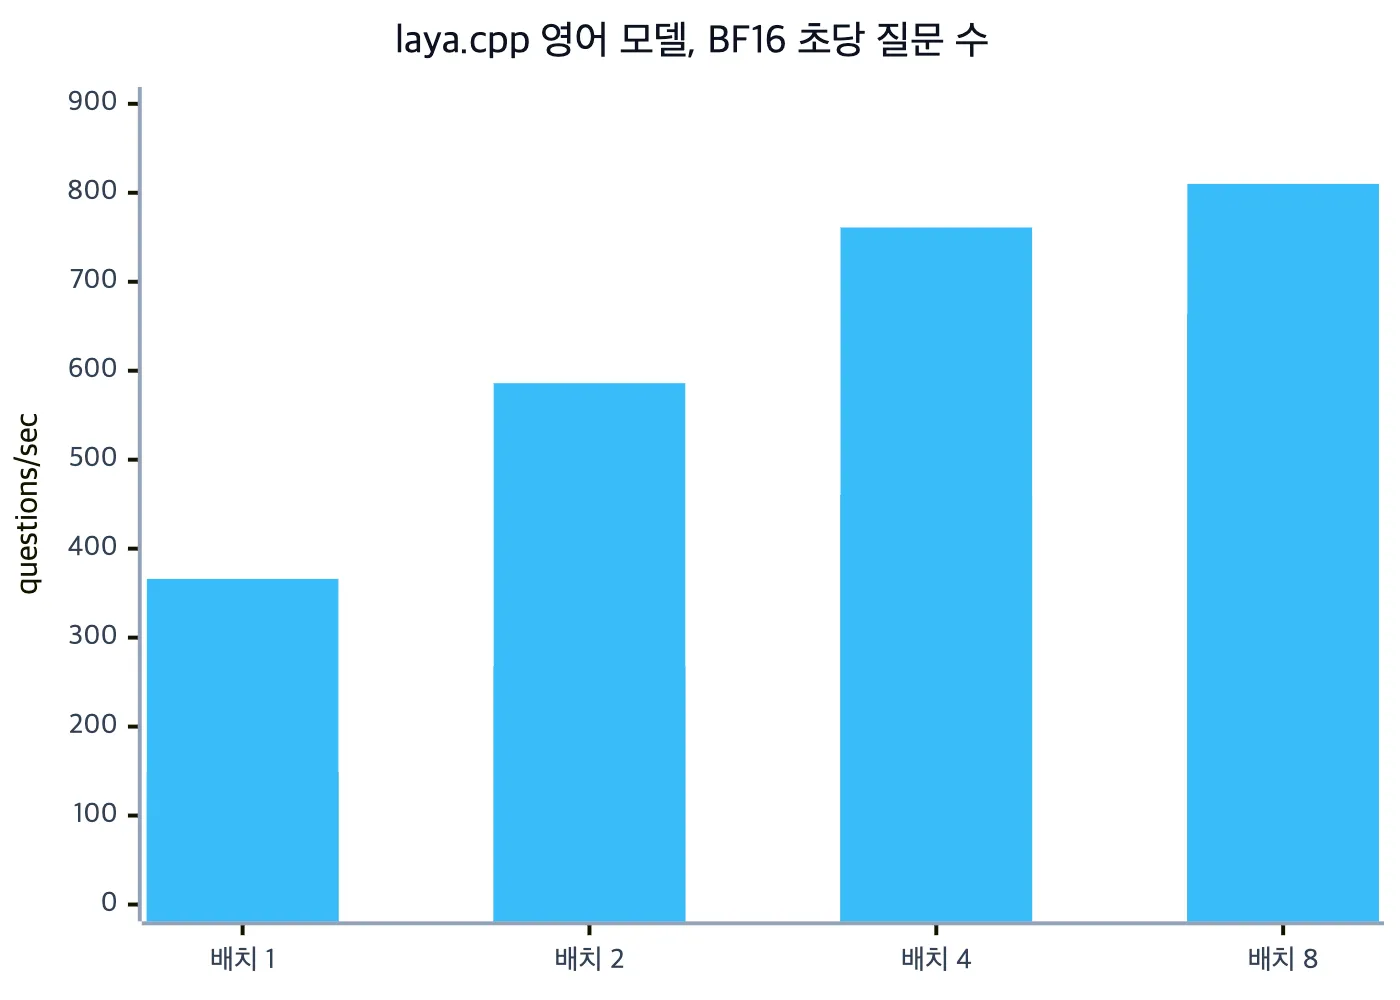
배치 1에서 2배 넘게 벌어집니다. 사내 티켓 분류처럼 요청이 띄엄띄엄 들어오는 워크로드라면 이 차이가 체감됩니다.
2. 별도 모델 없이 분류기 만들기
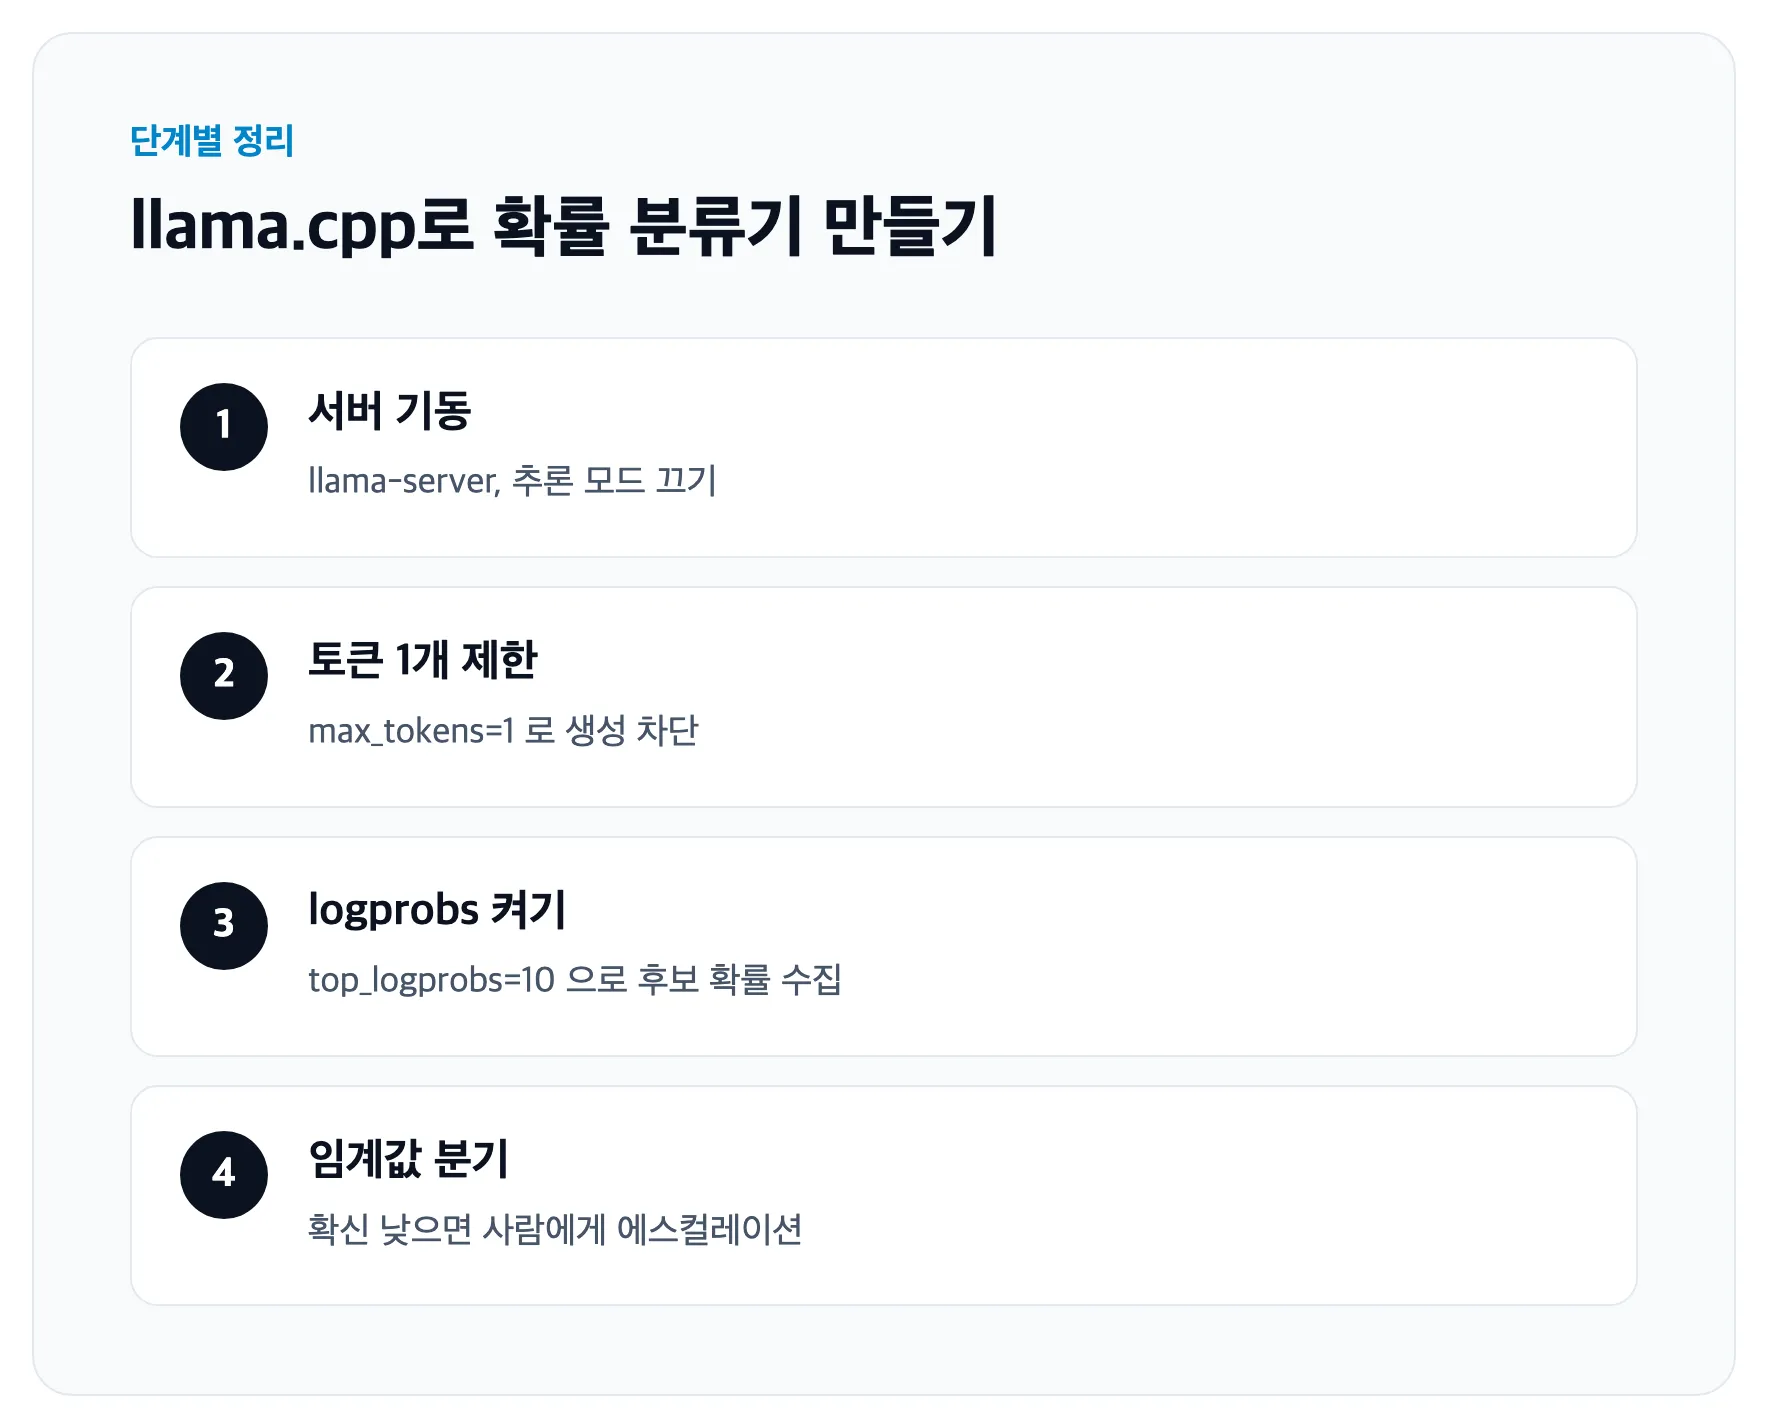
실무적으로 오늘 가장 쓸 만한 글은 이겁니다커뮤니티. 이미 갖고 있는 를 llama.cpp로 띄우고, 1개만 생성하게 한 뒤 를 읽으면 끝입니다.
llama-server -m models/내모델-Q4_K_M.gguf \
-c 4096 -ngl all -fa on -b 2048 -ub 512 --reasoning off요청은 max_tokens: 1, logprobs: true, top_logprobs: 10으로 보냅니다. “스팸이면 1, 아니면 0만 답하라”는 시스템 프롬프트를 주면 응답에 1 = 94.9%, 0 = 5.08% 식의 확률이 같이 딸려 옵니다. 임계값을 0.9로 잡고 그 아래는 사람에게 넘기는 식의 분기가 바로 만들어집니다.
더 정교하게 간 사례도 있습니다. DIY Jev커뮤니티 글쓴이는 후보 답마다 “이게 최선의 답인가”를 참/거짓으로 묻고 그 로짓 차이를 소프트맥스한 방식으로, 32,235개 예제 벤치에서 Qwen3-4B 65.0%(초당 약 27건), Qwen3 27B 75.3%(약 2.9건), Qwen3.6 35B-A3B 75.5%(약 5건)를 기록했다고 합니다. 노트북 5090 24GB 기준입니다. 4B가 27B 대비 10배 가까운 처리량에 정확도는 10%p 차이라는 점이 중요합니다. 분류 작업에서 큰 모델을 쓰는 건 대개 낭비예요.
3. Qwen-Image-2.1, 7B로 투명 배경까지
Qwen-Image-2.1커뮤니티이 오픈웨이트로 나왔습니다. 7B 경량 구조에 생성과 편집이 한 모델에 들어 있고, RGBA 레이어를 네이티브로 다룹니다. 투명 배경 이미지를 바로 만들고 그 안의 텍스트를 편집할 수 있다는 뜻입니다. 참조 이미지는 최대 10장까지 받습니다. 맨 위 사진이 공식 저장소공식 화면입니다.
발표에 따르면 파노라마, 인포그래픽, 가상 피팅에 강하다고 합니다. 투명 배경을 바로 뽑아 주니 합성 작업이 많은 쪽에서는 반가운 기능입니다.
라이선스는 **Qwen Research License공식**입니다. 연구·평가 목적으로만 쓸 수 있고, 제품 상세 페이지처럼 돈이 오가는 곳에 쓰려면 Qwen에 상업 라이선스를 따로 받아야 합니다.
지금은 사내에서 품질을 시험해 보는 정도가 맞습니다.
4. ZCode 오픈소스화, 보안 사고 뒤에
ZCode가 오픈소스로 전환커뮤니티됐습니다. 데스크톱 앱, 웹 워크스페이스, 백엔드, 에이전트 CLI, 런타임이 모두 포함됩니다. 배경은 좋지 않습니다. 커뮤니티가 보안 문제를 제기했고, 그 대응으로 v3.14.0에서 Repo Wiki 기능을 제거하고 코드를 공개한 겁니다. 회사 측은 문제가 된 코드 데이터는 보관하지도, 학습에 쓰지도 않았다고 밝혔고 CAICT와 NSFOCUS 평가 결과도 함께 공개했습니다.
교훈은 단순합니다. 사내 코드를 훑는 코딩 에이전트를 붙일 때는 “어디로 무엇을 올리는가”를 먼저 확인해야 합니다. 저장소 전체를 인덱싱해 클라우드로 보내는 기능이 기본값으로 켜져 있는 도구가 생각보다 많습니다.
오늘 할 일
반복되는 분류 업무가 하나라도 있다면, 오늘은 llama-server를 max_tokens=1, logprobs=true로 한 번 띄워 보세요. 문의 메일 50건만 넣어 보면 확률 분포가 쓸 만한지 30분 안에 판단됩니다. 그리고 쓰고 있는 코딩 에이전트의 저장소 업로드 설정을 한 번 열어 확인하시고요.
덧붙여 3090 한 장으로 Qwen 3.8 27B 에이전트를 21일 돌린 기록커뮤니티도 읽어 볼 만합니다. 사람 메시지 12개로 3주를 굴렸지만 압축에만 83시간이 들었고, 만든 CUDA 엔진은 llama.cpp를 이기지 못했습니다. 오래 돌린다고 결과가 나오는 건 아니라는 기록이라 더 값집니다.
참고한 자료 · 9건
- 공식 · 2
- Qwen-Image-2.1 모델 카드 (라이선스 원문)huggingface.co
- QwenLM/Qwen-Image-2.1 저장소github.com
- 커뮤니티 · 7 — 소식을 찾은 곳. 사실 확인은 공식 자료로
- convaiinnovations/laya (multilingual, non-autoregressive System 1 decision model)reddit.com
- laya.cpp: Optimized laya near-instant decision makingreddit.com
- You can use any LLM just like JEVreddit.com
- DIY Jevreddit.com
- Qwen-Image-2.1 released!reddit.com
- ZCode is now open sourcereddit.com
- The bear can dance: Qwen 3.8 27B on one 3090 for 3 weeksreddit.com
수정 이력
이어서 읽기
이번 주 해외에서 새로 나온 것 가운데 일에 쓸 만한 것만 골라, 원문 링크와 함께 보내 드립니다.
팀에 이런 자동화를 들이고 싶다면 강의·도입 문의로 연락 주세요.